









Så fungerar docs.placepoint.no
Placepoint publicerar 1 200+ sidor produktdokumentation på norska och engelska utan manuellt skrivande. Så fungerar pipelinen bakom docs.placepoint.no.
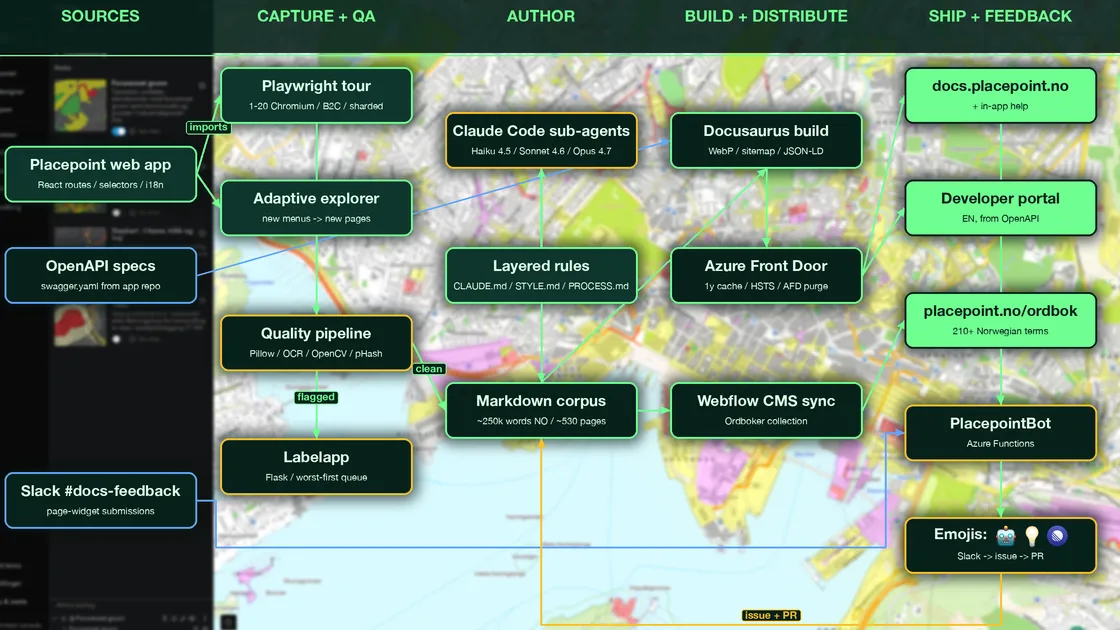
Jag började på Placepoint den 20 april, och något av det första jag ville bygga var en levande produktdokumentation. Inte en statisk ”så använder du Placepoint”-sida som är inaktuell dagen efter att ny funktionalitet lanseras, utan något som uppdateras automatiskt i takt med produkten.
Det är det vi har byggt på docs.placepoint.no. 1 200+ sidor på norska och engelska. 7 000+ skärmbilder. Över 250 huvudkartlager dokumenterade. 140+ dataset från 30 leverantörer. En ordlista med 300+ verifierade norska fastighetsbegrepp, med källhänvisningar till Lovdata, Kartverket, Brønnøysundregistrene, NVE och SSB. En egen utvecklarportal genererad från OpenAPI-specifikationerna.
Ingen människa har skrivit en enda mening av detta. Pipelinen byggdes på två till tre veckor.
Det är fortfarande inte färdigt. Fusion-dokumentationen är ganska skakig, och vi hittar saker varje dag som kan bli bättre. Men det funkar.
Varför automatisera dokumentationen
Dokumentation är en av de svåraste sakerna att hålla uppdaterad i ett mjukvaruföretag. Varje gång produkten förändras borde dokumentationen följa med, men det sker sällan i praktiken. Många företag av Placepoints storlek skulle ha haft en egen avdelning för teknisk skrivning och översättning. Vi har valt en annan väg.
När du som kund undrar över något, vare sig det är en funktion, en datasetgräns eller ett begrepp, ska svaret vara ett klick bort. Det ska vara uppdaterat samma dag som funktionaliteten ändras, och tillgängligt både som fristående webbplats och som hjälp inne i Placepoint-webbappen.
Så fungerar pipelinen
Pipelinen består av tre tekniska lager som hänger ihop.
Navigering (TypeScript, Playwright, Chromium). TypeScript-skript driver headless Chromium, alltså utan synligt webbläsarfönster, genom hela Placepoint-appen via Playwright. Skripten importerar webbappens React-routes och navigerar som en kund skulle ha gjort: loggar in via Azure B2C, öppnar varje panel, aktiverar varje kartlager, skriver i sökfält och håller muspekaren över ikoner. Tusentals klick per körning, fördelade på 1 till 20 webbläsare parallellt. En adaptiv utforskare upptäcker nya menyer, flikar och hover-element och skapar nya dokumentationssidor automatiskt. Säljavdelningen kan använda exempelsidorna för kommuner och kunder med konkreta organisationsnummer. Alla är genererade automatiskt.
Skrivande (Claude Code). Själva skrivandet görs i Claude Code, mest i terminalfönster (iTerm2) och lite i Cursor. Subagenter fördelar uppgifterna mellan tre modeller från Anthropic: en snabb modell för enkla saker, en mellanklass för det som är lite mer avancerat, och den kraftfullaste när det verkligen gäller. Ett hierarkiskt regelsystem styr det hela: CLAUDE.md per komponent, STYLE.md för språkstilar, PROCESS.md för arbetsflöde och PLAN.md för hur uppgifter ska utföras. Det säkerställer effektiv användning av agenter och tokens utan konstant mänsklig styrning. Git worktrees låter flera sessioner arbeta i samma repo parallellt. Mina globala regler för Claude Code finns öppet på GitHub.
Kvalitet (Python, Pillow, OpenCV, pytesseract). Alla PNG-skärmbilder kontrolleras automatiskt. Python med Pillow, NumPy och SciPy fångar tomma kartlager och halvt laddade tiles. pytesseract känner igen text i norska och engelska felmeddelanden. OpenCV upptäcker tooltips, laddningsindikatorer och felikoner. imagehash flaggar bilder som plötsligt ser ut som en annan sida i appen. Det som flaggas hamnar i en specialbyggd webbapp för mänsklig klassificering, och varje etikett där blir en rättelse i navigeringsskripten.
Dokumentationen omfattar runt 300 000 ord norsk Markdown. Docusaurus bygger statiska sidor. Ordlistan synkroniseras också till Sanity, CMS:et bakom placepoint.no, så begreppen finns på båda webbplatserna. Diagrammet överst visar Webflow, vårt tidigare CMS.
Norska i en AI-värld
Ett föga känt problem med norska LLM-lösningar är att norska är ett böjningsspråk med dialekter och fackterminologi som inte hanteras väl som standard. Vi har byggt runt 2 500 AI-genererade synonymuppslag som täcker böjningar och regionala varianter, uppdaterade mot hela dokumentationen vid varje bygge.
Resultatet är att en användare som söker ”kartlag for vegetasjon” hittar rätt sida även om källtexten säger ”naturtype”. En snabb modell expanderar och omformulerar frågan, Algolia söker i indexet, och en starkare modell rangordnar resultaten på nytt.
Användardokumentationen är skriven på norskt klarspråk för fastighetsbranschen. Utvecklardokumentationen är på precis, teknisk engelska genererad från OpenAPI-specifikationerna. Samma pipeline, två röster för två målgrupper.
Pipelinen lär sig av kunderna
Tre Slack-emojier får Slack-boten PlacepointBot att göra saker. Robotreaktionen låter den svara i tråden med den mest relevanta dokumentlänken, driven av en Azure Function. Glödlampsreaktionen gör en brist i dokumentationen till en issue och en pull request på GitHub. Triviala korrigeringar går snart rakt igenom, större ändringar väntar på mänskligt godkännande. En Linear-reaktion skapar eller grupperar en uppgift i Linear.
Varje kundförfrågan gör produkten bättre. Det är inte längre en fråga om vad vi prioriterar av features kontra buggar. Det är en pipeline som fungerar som ett självförstärkande inlärningssystem.
Byggt på spårvagnen
En detalj som säger något om hur vi arbetar nu: den första versionen av kvalitetskontrollsystemet byggdes på en telefon.
En morgon i maj satt jag på spårvagnen i Oslo med ett problem. Kvalitetskontrollen som skulle fånga upp dåliga skärmbilder hade fortfarande ett hål, och en del bilder med tomma kartlager, halvt laddade paneler och tooltips som dök upp vid fel tidpunkt slank igenom. Jag öppnade Claude-appen på iPhone, fjärrstyrde Claude Code-sessionen som körde på Macen på kontoret och byggde den första fungerande versionen av webbappen för manuell klassificering på spårvagnen.
Ett quiz som började som ett internskämt
Vi har också gjort ett quiz baserat på dokumentationen, ordlistan och kundförfrågningar från de senaste 24 månaderna. Det började som ett internskämt. Nu använder vi det bland annat för att träna upp en AI-assistent för Customer Success-teamet, och för att hitta hål i dokumentationen som vi annars inte hade upptäckt. Quizet är öppet för alla: docs.placepoint.no/quiz.
Vad detta betyder i praktiken
Alltid uppdaterad dokumentation. Sökning som faktiskt förstår norska. Komplett översikt över kartlager, dataset, leverantörer och begrepp, dokumenterad med källhänvisningar till Brønnøysundregistrene, Kartverket, Matrikkelen, NVE, SSB och andra primärkällor.
Dokumentationen som kunderna läser i dag är också träningsunderlaget för AI-assistenten som är under utveckling. Den ska så småningom hjälpa kunderna att utföra själva arbetet i Placepoint. Produkten dokumenterar sig själv och bygger samtidigt sitt eget underlag för att bli smartare.
Se dokumentationen på docs.placepoint.no. Saknar du något, eller hittar du något som är fel? Säg bara till.
Läs vidare
AI förvandlar fastighetsbranschen: Potential möter praktiska utmaningar
Artificiell intelligens förändrar fastighetsbranschen. Läs om möjligheterna och utmaningarna som branschen står inför.
TeknikProptech är inte längre ett tillvalsämne i fastighetsbranschen
Proptech har gått från nischintresse till konkurrensfördel. Teknik är nu obligatoriskt inom fastighetsbranschen.
TeknikSe utvecklingspotentialen på tomter på ett ögonblick
Med Placepoint ser du snabbt utvecklingspotentialen på varje tomt. Fatta bättre beslut med data.